LLM / AI, Technical SEO
AI-Crawler Steuerung: ChatGPT & KI sperren oder freigeben
Die zunehmende Verbreitung und Nutzung von LLMs (Large-Language-Models) und KI-getriebenen Suchsystemen verändert das Crawling-Fundament des Webs in einem erheblichen Tempo: Zugriffe von AI-Crawlern wie GPTBot, ClaudeBot, Google-Extended oder PerplexityBot auf Websites sind in den letzten Monaten stark angestiegen und ein Ende wird wohl über das nächste Jahrzehnt nicht in Sicht sein.1
Gleichzeitig zeigt sich, dass der Nutzertraffic über LLM-Verweise einen spürbaren Aufwind bekommt. In dieser Dynamik ist für viele Unternehmen und Website-Betreiber wichtig geworden, ein Gleichgewicht zwischen Sichtbarkeit in KI-Ergebnissen und Schutz geistigen Eigentums herzustellen. Der EU-AI-Act (Art. 53)2 verlangt zudem ein maschinenlesbares Opt-out für Trainingszwecke. Cloudflare reagiert als erste Plattform und blockiert KI-Crawler seit Juli 2025 als Standardeinstellung, sofern keine explizite Erlaubnis (oder monetärer Ausgleich) erfolgt.3
Dabei gilt: Nicht jeder Website-Betreiber möchte, dass die eigenen Inhalte zum Trainieren von KI-Modellen genutzt werden. Ein pauschales Blockieren ist jedoch nicht zielführend, denn Traffic-Quellen wie ChatGPT-Search oder Perplexity generieren echte Klicks.
Der Schlüssel liegt in einer strukturierten AI-Crawler / LLM-Bot-Steuerung – möglich dank einer zunehmend differenzierten Crawler-Typisierung durch viele LLM-Anbieter. Während einige Bots wie GPTBot primär fürs Modelltraining eingesetzt werden, dienen andere wie der OAI-SearchBot der Antwortgenerierung oder Echtzeitsuche. Diese Unterscheidung erlaubt es, gezielt Zugriff und Nutzung zu steuern, statt „alles oder nichts“ zu blockieren.
Welche deutschen Websites blockieren LLMs & ChatGPT?
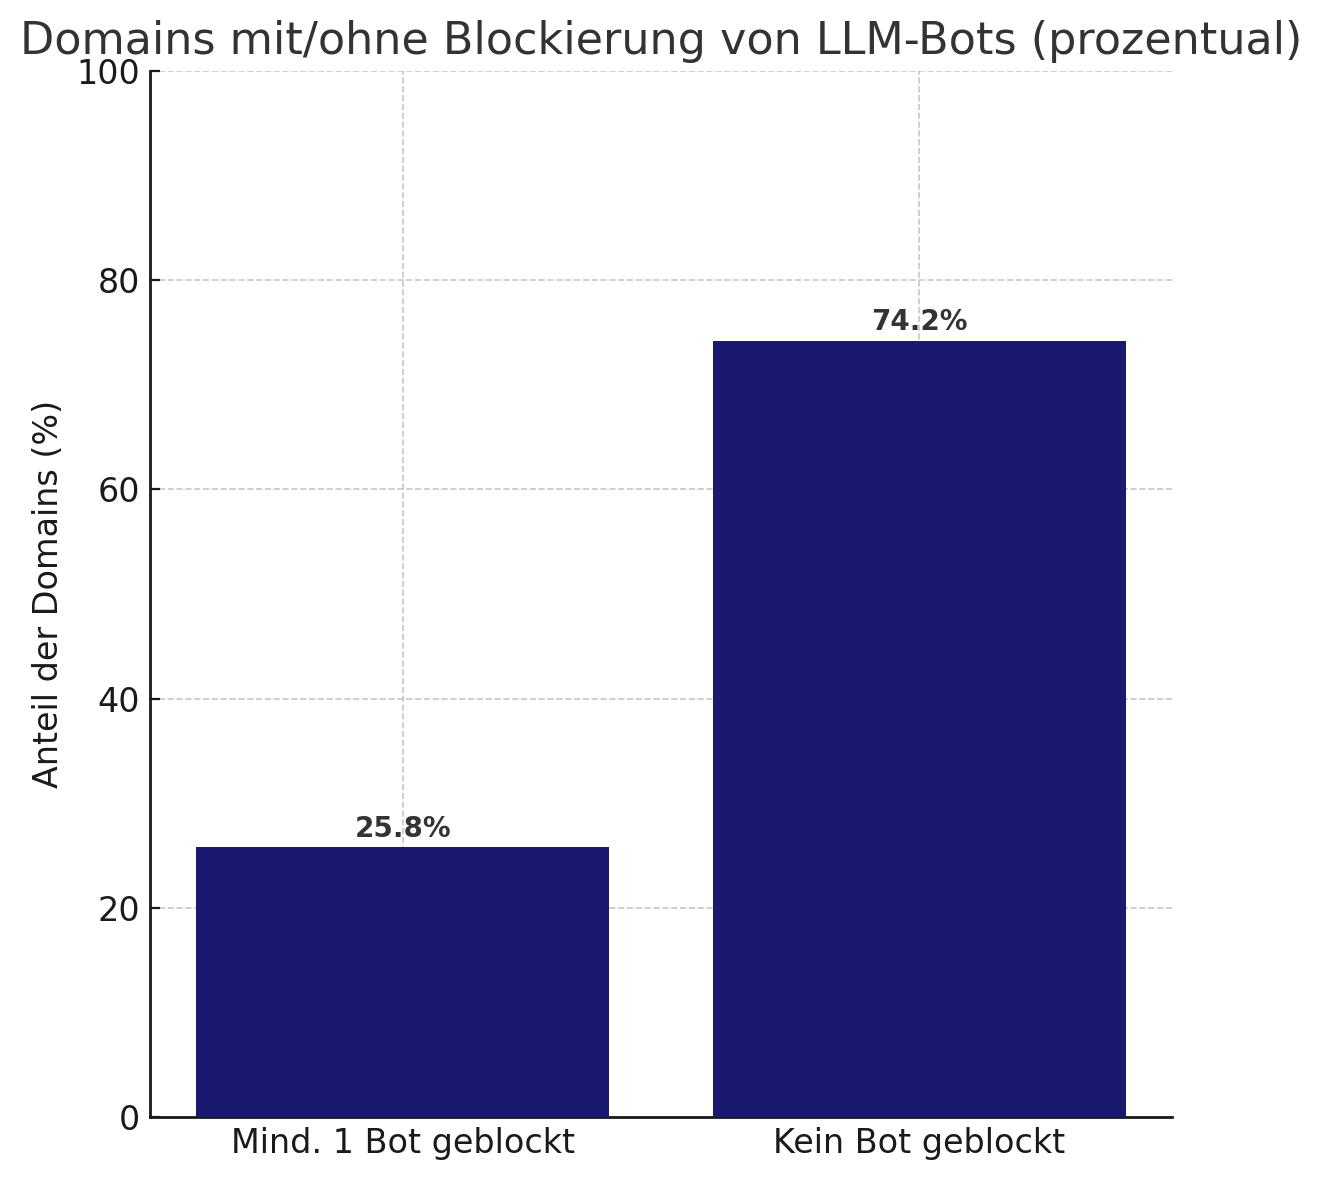
In einer Auswertung der robots.txt Dateien der Top 492 sichtbarkeitsstärksten Domains in Deutschland (nach Sistrix) konnte ich folgende Keyfacts identifizieren (Stand: Juli 2025):
- 25,8% der Domains blocken mindestens ein LLM
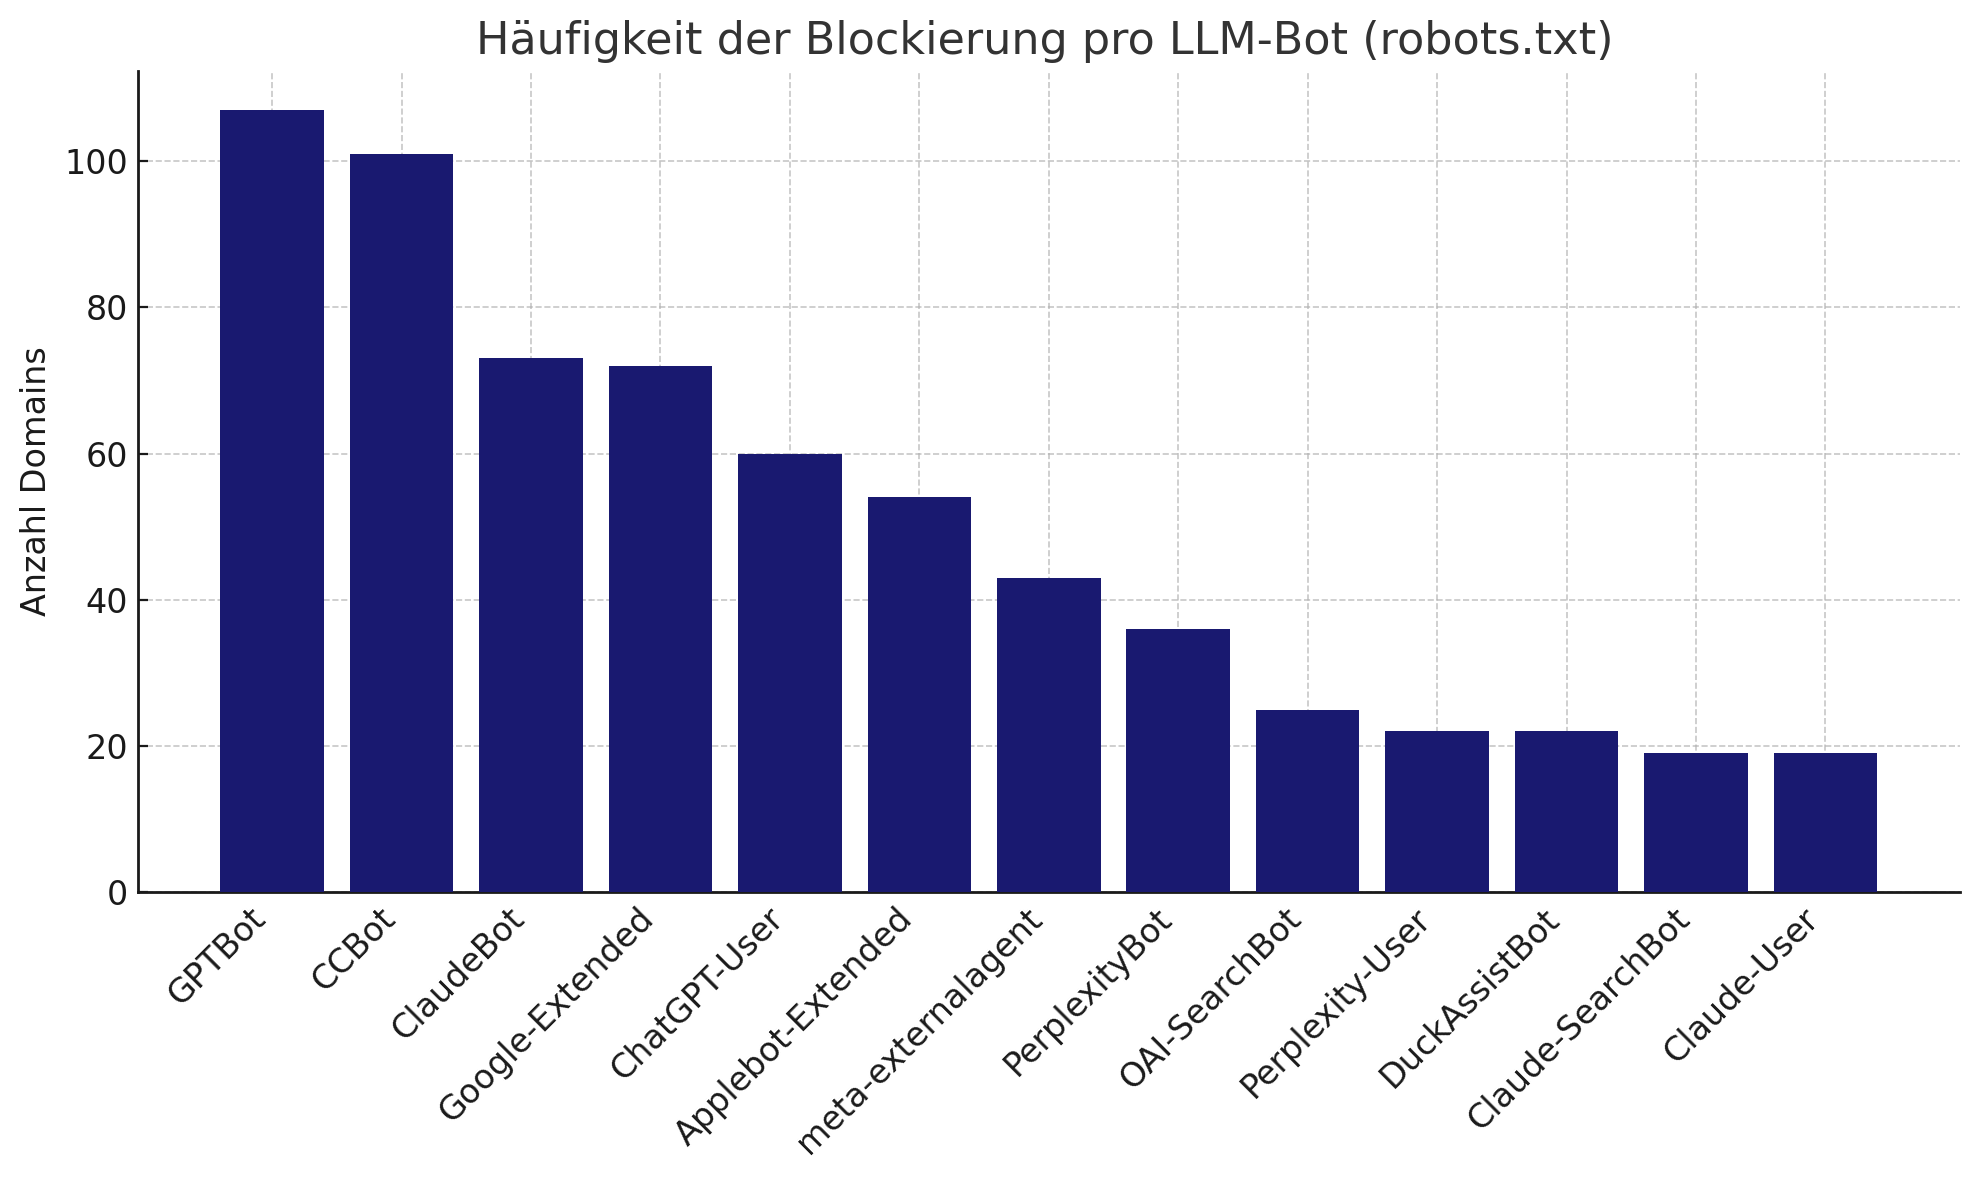
- 60 % aller Blocker setzen ausschließlich auf minimalistische Listen (1–2 Bots). Ein kompletter -“Kill Switch” (= alle 13) bleibt mit 15 Domains die Ausnahme.
- 28 Domains blocken aus der Auswahl ausschließlich den GPTBot und 6 Domains Google-Extended
- Fun-Fact: 37 Domains nutzen falsch geschriebene UA-Strings
Folgende AI-Bots wurden geprüft: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, Google-Extended, Applebot-Extended, meta-externalagent, DuckAssistBot, CCBot
ChatGPT sperren – Zahlen, Motive & Trends
Immer mehr Website-Betreiber sperren den Zugriff von ChatGPT – und zwar vor allem den für das Learning zuständigen GPTBot. Die aktuelle Analyse zeigt: Rund 20% dieser Websites verwehren ausdrücklich dem GPTBot den Zutritt, deutlich häufiger als jedem anderen KI-Crawler (nur 4,9% sperren alle drei User-Agents von OpenAI und 12,2% den interaktiven ChatGPT-User-Agent). Besonders konsequent handeln dabei Verlage und Fachportale; sie schützen ihre Inhalte im Vergleich deutlich stärker vor automatischem Auslesen durch generative KI als zum Beispiel E-Commerce.
Öffentliche Einrichtungen dagegen sperren ChatGPT weitaus seltener. Behörden- und Städte-Websites haben vermutlich eher eine Pflicht zur Transparenz und fürchten kein unmittelbares Geschäftsrisiko durch Content-Scraping.
Auffällig: Wer blockt, blockt selten allein… In neun von zehn Fällen steht GPTBot nicht isoliert in der robots.txt, sondern gemeinsam mit weiteren KI-Bots wie ClaudeBot oder PerplexityBot. Gleichwohl finden sich vereinzelte Domains, die bisher nur den GPTBot ausschließen.
Es wird spannend sein zu beobachten, wie sich der Trend über die nächsten Monate und Jahre entwickelt.
Domains mit/ohne Blockierung von LLM Bots
Häufigkeit der Blockierung pro LLM-Bot
AI-Crawler Typisierung
Nachfolgende Übersicht zeigt die aktuell verwendeten KI-Bots bzw. ihre User-Agents der etablierten Anbieter und ihren primären Einsatzzweck:
| Anbieter | KI-Bot | User-Agent | Primärer Zweck | Dokumentation |
|---|---|---|---|---|
| OpenAI | GPTBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.1; +https://openai.com/gptbot | Modell-Training | OpenAI Docs |
| OAI-SearchBot | contains: OAI-SearchBot/1.0; +https://openai.com/searchbot | Suche | ||
| ChatGPT-User | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot | User-Triggered Fetcher | ||
| Anthropic | ClaudeBot | contains: ClaudeBot | Modell-Training | Anthropic Support |
| Claude-SearchBot | contains: Claude-SearchBot | Suche | ||
| Claude-User | contains: Claude-User | User-Triggered Fetcher | ||
| Perplexity AI | PerplexityBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot) | Suche | Perplexity Docs |
| Perplexity-User | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user) | User-Triggered Fetcher | ||
| Alphabet / Google | Google-Extended | contains: Google-Extended | Modell-Training | Google Developers |
| User-Triggered Fetchers | Diverse | User-Triggered Fetcher | Google Developers | |
| Microsoft / Bing | Bingbot | contains: Bingbot | Search-Index & optional Training | Bing Blog |
| Apple | Applebot | contains: Applebot | Spotlight / Siri Suche | Apple Support |
| Applebot-Extended | contains: Applebot-Extended | Modell-Training | ||
| Amazon | Amazonbot | contains: Amazonbot | Alexa Q&A-Index | Amazon Developers |
| Meta | meta-externalagent | contains: meta-externalagent | Modell-Training | Meta Developers |
| DuckDuckGo | DuckAssistBot | contains: DuckAssistBot | User-Triggered Fetcher | DuckDuckGo Help |
| Common Crawl | CCBot | contains: CCBot | Modell-Training | CommonCrawl |
Die 4 Ebenen der AI-Crawler-Steuerung
Die Steuerung von AI-Crawlern lässt sich über unterschiedliche Ebenen umsetzen. Jede Ebene adressiert einen anderen Angriffspunkt im Crawler-Lebenszyklus – vom ersten HTTP Request bis zur Weiterverwendung der Daten im Modell.
- robots.txt – Zugriffskontrolle
Die Robots Exclusion Protocol-Datei legt fest, ob ein Bot eine URL überhaupt abrufen darf. Sie wird von den meisten etablierten LLM-Crawlern respektiert (GPTBot, ClaudeBot, Google-Extended u. a.). - Robots-Meta-Tag / X-Robots-Tag – Nutzungskontrolle
Header- oder Meta-Direktiven wienoai(Modell-Training über Texte untersagt) odernoimageai4 (Modell-Training über Bilder untersagt) oder auch können die Kontrolle auf die Verwendungsebene erweitern. Hier sei jedoch angemerkt, dass es sich zum aktuellen Zeitpunkt lediglich um einen Vorschlag handelt, den diverse Unternehmen und Einzelautoren aufgegriffen haben und ursprünglich Deviantart ins Spiel gebracht hat. Sie sind zum aktuellen Zeitpunkt keine etablierte Direktive in aktiver Nutzung und kein Bestandteil einer offiziellen Spezifikation. - Netzwerk-Filter und Rate-Limit
CDN- und WAF-Regeln (z. B. Cloudflare, Fastly, AWS WAF) können den Zugriff verhindern/einschränken oder erlauben ein Whitelisting direkt auf Netzwerkebene. Gleichzeitige IP-/ASN-Validierung / ReverseDNS schützt vor Spoofing, während dynamische Rate-Limits Serverressourcen schonen können. Diese Ebene ist die technisch verlässlichste. - Lizenz- und Monetarisierungslayer
Inai-policy.jsonoder einem künftigenusage-rights-Meta-Tag5 lassen sich Nutzungszwecke (Search, Training, Commercial usw.) sowie Vergütungsmodelle maschinenlesbar deklarieren. Noch handelt es sich um einen Industrie-/Community-Entwurf, doch CDN-Anbieter wie Cloudflare testen bereits in Ansätzen Pay-Per-Crawl-Flows6. Diese Ebene soll perspektivisch die heute fehlende wirtschaftliche Komponente schließen.
| Ebene | Zweck | Standard | Verlässlich? |
|---|---|---|---|
| robots.txt | Crawl ja/nein | REP (RFC 9309) | überwiegend |
| Robots-Meta-Tag & X-Robots-Tag | Nutzung steuern | IETF-Draft (noai, noimageai, DisallowAITraining etc.); Bing (nocache/noarchive), Amazon (noarchive) | aktuell überwiegend nur als Vorschlag vorhanden bis auf nocache/noarchive von Bing und noarchive von Amazon |
| Rate-Limit / ASN-Filter / Whitelist / Blacklist | Abuse & Spoofing blockieren / Whitelisting / Blacklisting | CDN-/WAF-Rules | ja |
| Lizenzierung | Lizenzierung und Monetarisierung regeln | ai-policy.json / Meta-Tag usage-rights | mögliche Zukunft / Proposal |
Aktuelle AI-Crawler‑Compliance‑Matrix (Juli 2025)
Im Gesamtbild der unterschiedlichen Steuerungsmöglichkeiten hat sich die robots.txt oder auch eine harte Steuerung des Zugriffs über Netzwerksperren (CDN/WAF etc.) der AI-Crawler etabliert.
| Provider | User-Agent(s) | robots.txt | noai / noimageai / NOARCHIVE / NOCACHE |
|---|---|---|---|
| OpenAI | GPTBot, ChatGPT-User, OAI-SearchBot | Ja | Nein |
| Anthropic | ClaudeBot, anthropic-ai | Ja | Nein |
| Perplexity | PerplexityBot | Ja | Nein |
Google-Extended | Ja | Nein | |
| Microsoft / Bing | BingBot | Ja | Nein, Alternative: NOARCHIVE / NOCACHE |
| Apple | Applebot, Applebot-Extended | Ja | Nein |
| Amazon | Amazonbot | Ja | Nein, Alternative: NOARCHIVE |
| Meta | meta-externalagent | Teilweise | Nein |
| Common Crawl | CCBot | Ja | Nein |
Beispiel-Konfiguration einer robots.txt
Folgendes Beispiel zeigt exemplarisch einen Crawling-Ausschluß für die angebenen User-Agents in der robots.txt:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Offizielle IP-Listen der LLM-Anbieter
- OpenAI
- Anthropic
- Perplexity
- Google
- https://developers.google.com/search/apis/ipranges/googlebot.json
- https://developers.google.com/search/apis/ipranges/special-crawlers.json
- https://developers.google.com/search/apis/ipranges/user-triggered-fetchers.json
- https://developers.google.com/search/apis/ipranges/user-triggered-fetchers-google.json
- Bing
- DuckDuckGo
Quellen
[1] https://blog.cloudflare.com/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/
[2] https://eur-lex.europa.eu/legal-content/DE/TXT/HTML/?uri=OJ:L_202401689
[3] https://www.cloudflare.com/de-de/press-releases/2025/cloudflare-just-changed-how-ai-crawlers-scrape-the-internet-at-large/
[4] https://www.deviantart.com/team/journal/UPDATE-All-Deviations-Are-Opted-Out-of-AI-Datasets-934500371
[5] https://searchengineland.com/robots-txt-new-meta-tag-llm-ai-429510
[6] https://blog.cloudflare.com/introducing-pay-per-crawl/